Rechnen zu können ist für Computer zentral
Betrachtete Rechenoperationen
Betrachtete Datentypen
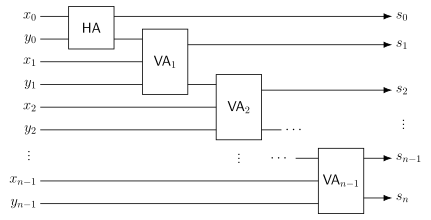
Addition natürlicher Zahlen
Schulalgorithmus für die Addition von Dezimalzahlen
\[ \begin{array}{l|cccccccc} \text{1. Summand} & & 9 & 3 & 8 & 9 & 9 & 8 & 9\\ \text{2. Summand} & & & 9 & 7 & 9 & 8 & 9 & 8\\ \text{Übertrag} & 1 & 1 & 1 & 1 & 1 & 1 & 1 & \\ \hline \text{Summe} & 1 & 0 & 3 & 6 & 9 & 8 & 8 & 7 \end{array} \]
Übertragung auf Binärzahlen
\[ \begin{array}{l|cccccccc} \text{1. Summand} & & 1 & 1 & 0 & 0 & 1 & 1 & 1\\ \text{2. Summand} & & 1 & 0 & 0 & 1 & 0 & 1 & 1\\ \text{Übertrag} & 1 & & & 1 & 1 & 1 & 1 & \\ \hline \text{Summe} & 1 & 0 & 1 & 1 & 0 & 0 & 1 & 0 \end{array} \]
Beobachtung zu den Überträgen
Kann man Addition als Boolesche Funktion ausdrücken?
| \(x\) | \(y\) | \(c\) | \(s\) |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 0 | 1 | 0 | 1 |
| 1 | 0 | 0 | 1 |
| 1 | 1 | 1 | 0 |
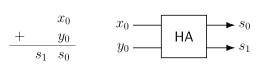
\(f_{HA}\) realisiert einen sog. Halbaddierer
\(f_{HA}:B^2\to B^2\)
| \(x\) | \(y\) | \(c\) | \(s\) |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 0 | 1 | 0 | 1 |
| 1 | 0 | 0 | 1 |
| 1 | 1 | 1 | 0 |
Schaltung für den Halbaddierer: \(\quad c=x\land y \qquad s=x\oplus y\)
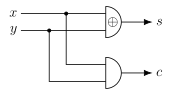
Wie viele Gatter benötigt ein Halbaddierer und wie tief ist ein Halbaddierer?
Beobachtung
Halbaddierer
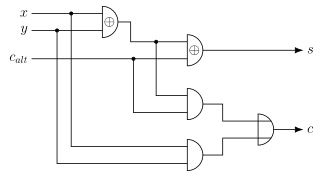
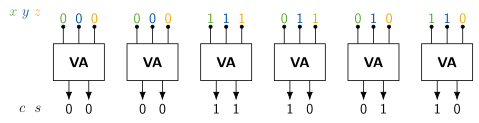
Volladdierer
| \(c_{alt}\) | \(x\) | \(y\) | \(c\) | \(s\) |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 |
| 0 | 0 | 1 | 0 | 1 |
| 0 | 1 | 0 | 0 | 1 |
| 0 | 1 | 1 | 1 | 0 |
| 1 | 0 | 0 | 0 | 1 |
| 1 | 0 | 1 | 1 | 0 |
| 1 | 1 | 0 | 1 | 0 |
| 1 | 1 | 1 | 1 | 1 |
Beobachtung für \(s\)
Beobachtung für \(c\)
| \(c_{alt}\) | \(x\) | \(y\) | \(c\) | \(s\) |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 |
| 0 | 0 | 1 | 0 | 1 |
| 0 | 1 | 0 | 0 | 1 |
| 0 | 1 | 1 | 1 | 0 |
| 1 | 0 | 0 | 0 | 1 |
| 1 | 0 | 1 | 1 | 0 |
| 1 | 1 | 0 | 1 | 0 |
| 1 | 1 | 1 | 1 | 1 |
Es gilt bisher: \(c=xy\lor c_{alt}y\lor c_{alt}x\)
Wir müssen die Belegungen für \((c_{alt},x,y)\in\{(011),(101),(110),(111)\}\) realisieren
\(\Rightarrow c=c_{alt}(x\oplus y)\lor xy\)
| \(c_{alt}\) | \(x\) | \(y\) | \(c\) | \(s\) |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 |
| 0 | 0 | 1 | 0 | 1 |
| 0 | 1 | 0 | 0 | 1 |
| 0 | 1 | 1 | 1 | 0 |
| 1 | 0 | 0 | 0 | 1 |
| 1 | 0 | 1 | 1 | 0 |
| 1 | 1 | 0 | 1 | 0 |
| 1 | 1 | 1 | 1 | 1 |
| \(c_{alt}\) | \(x\) | \(y\) | \(c\) | \(s\) |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 |
| 0 | 0 | 1 | 0 | 1 |
| 0 | 1 | 0 | 0 | 1 |
| 0 | 1 | 1 | 1 | 0 |
| 1 | 0 | 0 | 0 | 1 |
| 1 | 0 | 1 | 1 | 0 |
| 1 | 1 | 0 | 1 | 0 |
| 1 | 1 | 1 | 1 | 1 |
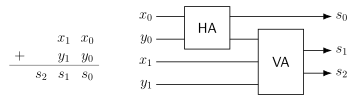
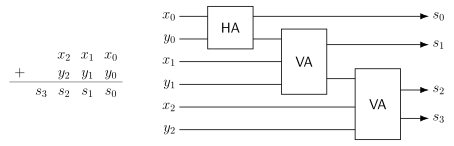
Realisierung „Addition von natürlichen Zahlen“
Warum ist unser Schaltnetz so tief?
Dieses Verhalten ist sehr gut durch einen Halbaddierer realisierbar
Zentrale Beobachtung
| \(x_i\) | \(y_i\) | \(u_i\) | \(v_i\) | Übertrag |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | eliminieren |
| 0 | 1 | 0 | 1 | weiterreichen |
| 1 | 0 | 0 | 1 | weiterreichen |
| 1 | 1 | 1 | 0 | generieren |
Notation
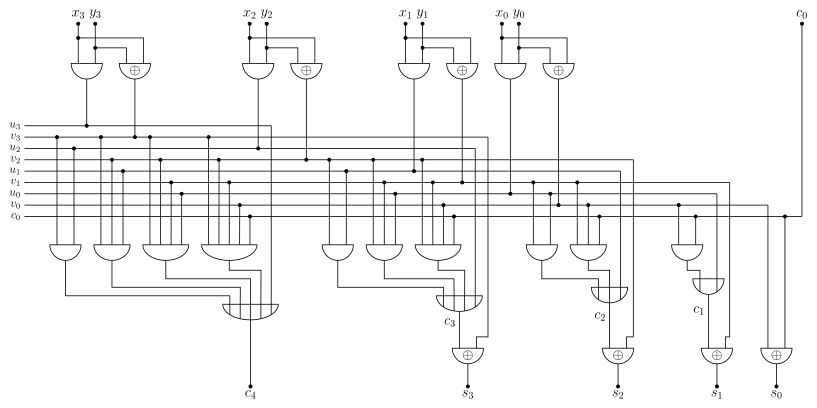
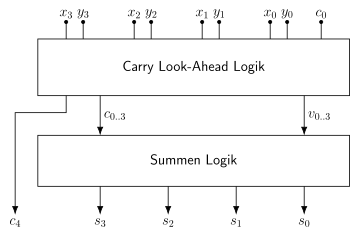
Vorausberechnung der Überträge
\[ c_i=u_{i-1}\lor c_{i-1}v_{i-1} \]
Notation
Vorausberechnung der Überträge
\[ \begin{aligned} c_1 &= u_0\\ c_2 &= u_1\lor u_0v_1\\ c_3 &= u_2\lor u_1v_2\lor u_0v_1v_2\\ c_4 &= u_3\lor u_2v_3\lor u_1v_2v_3\lor u_0v_1v_2v_3\\ c_i &= u_{i-1}\lor u_{i-2}v_{i-1}\lor u_{i-3}v_{i-2}v_{i-1}\lor\ldots\lor u_0v_1v_2\cdots v_{i-1} \end{aligned} \]
\[ c_i=\bigvee_{j=0}^{i-1}\Big(u_j\land\bigwedge_{k=j+1}^{i-1}v_k\Big) \]
Gesamttiefe des CLA: 4
| Baustein | Tiefe |
|---|---|
| Alle Halbaddierer (\(u_i,v_i\)) | 1 |
| Alle Und-Gatter \(\big(u_j\land\bigwedge_{k=j+1}^{i-1}v_k\big)\) | 1 |
| Großes Oder-Gatter | 1 |
| \(n\times\oplus\)-Gatter für korrekte Summenbits | 1 |
Quelle: Denis Pitzschel
Waren wir wirklich fair bei der Bestimmung der Ebenen?
Nehmen wir an, dass wir nur ODER-Gatter mit Fan-In 2 haben. Wie viele Gatter brauchen wir, um eine ODER-Logik mit Fan-In 16 zu implementieren?
Großes Fan-In systematisch verkleinern
Beispiel: ODER, Fan-In 16
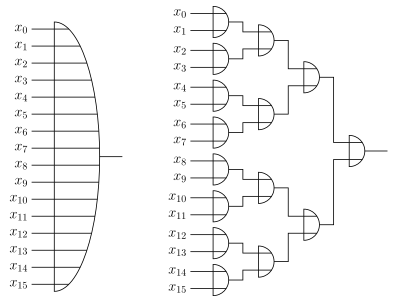
Waren wir wirklich fair bei der Bestimmung der Ebenen?
Ziel: Vergleichbarkeit herstellen
Am Beispiel
Wie lässt sich das verallgemeinern?
Realisierung der Addition von natürlichen Zahlen
Vergleich zum Ripple-Carry-Addierer
| \(n\) | Ripple-Carry Größe | Ripple-Carry Tiefe | Carry-Look-Ahead Größe | Carry-Look-Ahead Tiefe |
|---|---|---|---|---|
| 8 | 37 | 22 | 170 | 6 |
| 16 | 77 | 46 | 1365 | 8 |
| 32 | 157 | 94 | 10922 | 10 |
| 64 | 317 | 190 | 87381 | 12 |
Welcher Addierer ist besser?
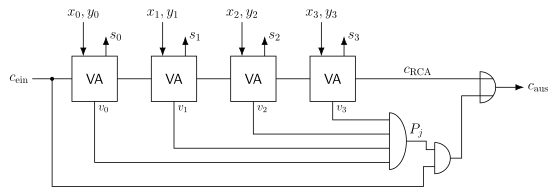
Schlechtester Fall im RCA: alle Stellen reichen den Übertrag weiter, d.h. \(v_i=1\) für alle \(i\)
\(\Rightarrow\) Der Übertrag \(c_0\) läuft durch alle \(n\) Volladdierer
Eigentlich ein einfacher Fall: Wenn alle Stellen weiterreichen, gilt \(c_n=c_0\)
Idee: mehrere kleine RCAs, jeder mit eigenem Propagate-Check
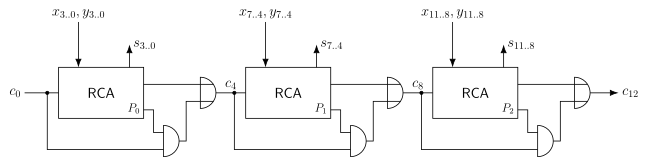
\[ c_{\text{aus}}=c_{\text{RCA}}\lor\big(P_j\land c_{\text{ein}}\big) \]
Multiplikation natürlicher Zahlen
Direkt mit Binärzahlen …
\[ \begin{array}{ccccccccccccccc} 1 & 0 & 1 & 0 & 1 & 1 & 0 & 0 & \cdot & 1 & 1 & 1 & 0 & 1 & 0\\ \hline & & & & & & & & & & & & & & 0\\ & & & & & & 1 & 0 & 1 & 0 & 1 & 1 & 0 & 0 & \\ & & & & & & & & & & & & 0 & & \\ & & & & 1 & 0 & 1 & 0 & 1 & 1 & 0 & 0 & & & \\ & & & 1 & 0 & 1 & 0 & 1 & 1 & 0 & 0 & & & & \\ & & 1 & 0 & 1 & 0 & 1 & 1 & 0 & 0 & & & & & \\ \hline & 1 & 0 & 0 & 1 & 1 & 0 & 1 & 1 & 1 & 1 & 1 & 0 & 0 & 0 \end{array} \]
Multiplizieren heißt
Multiplikation ist
Beobachtung
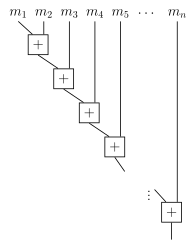
Erster Ansatz: Einfach nacheinander
Idee
Besserer Ansatz: Paarweise addieren
Bewertung
Gesamttiefe
\(\approx\log_2(n)\cdot 2\log_2(n)=2(\log_2(n))^2\)
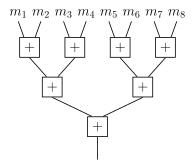
(Anzahl der zu addierenden Bitvektoren ist gleich der Anzahl Bits)
Gibt es einen noch besseren Ansatz?
Beobachtung
Zentral für uns
(Verrückte?) Idee: Vielleicht ist es einfacher, drei Zahlen zu ersetzen durch zwei Zahlen gleicher Summe?
Sei \(x=(001)\), \(y=(010)\), \(z=(011)\). Welche Bitvektoren \(a\) und \(b\) erfüllen die Bedingung \(x+y+z=a+b\)? (mehrere Auswahlmöglichkeiten)
Gibt es einen noch besseren Ansatz?
(Verrückte?) Idee: Vielleicht ist es einfacher, drei Zahlen zu ersetzen durch zwei Zahlen gleicher Summe?
Beobachtung
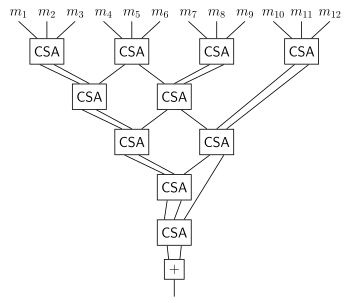
Wallace-Tree
Gesucht
Gefunden
Diese Volladdierer sind nicht verkettet
Wir addieren
\[ \begin{array}{lccccccccl} \text{Summen-Wort} & = & (0) & 0 & 0 & 1 & 0 & 1 & 0 & = 0001010\\ \text{Carry-Wort} & = & 0 & 0 & 1 & 1 & 0 & 1 & (0) & = 0011010 \end{array} \]
\[ \begin{array}{l|cccccccc} \text{Summand } x & & & x_5 & x_4 & x_3 & x_2 & x_1 & x_0\\ \text{Summand } y & + & & y_5 & y_4 & y_3 & y_2 & y_1 & y_0\\ \text{Summand } z & + & & z_5 & z_4 & z_3 & z_2 & z_1 & z_0\\ \color{gray}\text{Resultat} & & & \color{gray}2c_5+s_5 & \color{gray}2c_4+s_4 & \color{gray}2c_3+s_3 & \color{gray}2c_2+s_2 & \color{gray}2c_1+s_1 & \color{gray}2c_0+s_0\\ \hline \text{Carry-Wort} & & c_5 & c_4 & c_3 & c_2 & c_1 & c_0 & (0)\\ \text{Summen-Wort} & + & (0) & s_5 & s_4 & s_3 & s_2 & s_1 & s_0 \end{array} \]
\[ \begin{array}{l|cccccccc} \text{Summand } x & & & 0 & 0 & 1 & 0 & 0 & 1\\ \text{Summand } y & + & & 0 & 0 & 1 & 1 & 1 & 1\\ \text{Summand } z & + & & 0 & 0 & 1 & 1 & 0 & 0\\ \hline \text{Carry-Wort} & & 0 & 0 & 1 & 1 & 0 & 1 & (0)\\ \text{Summen-Wort} & + & (0) & 0 & 0 & 1 & 0 & 1 & 0\\ \hline \text{Summe} & & 0 & 1 & 0 & 0 & 1 & 0 & 0 \end{array} \]
Wie viele Schritte braucht es, \(c\) und \(s\) zu berechnen?
Berechnung von drei \(n\)-Bit-Zahlen
Beobachtung
Fazit: Multiplikation ist nicht wesentlich teurer oder langsamer als die Addition
Serielle Addierer
Paarweise Addierer
Wallace-Tree mit Carry-Save-Addierern
Welche Aussage ist korrekt, wenn \(n\) \(n\)-Bit-Vektoren mit einem Wallace-Tree addiert werden?